BigData
 BigData
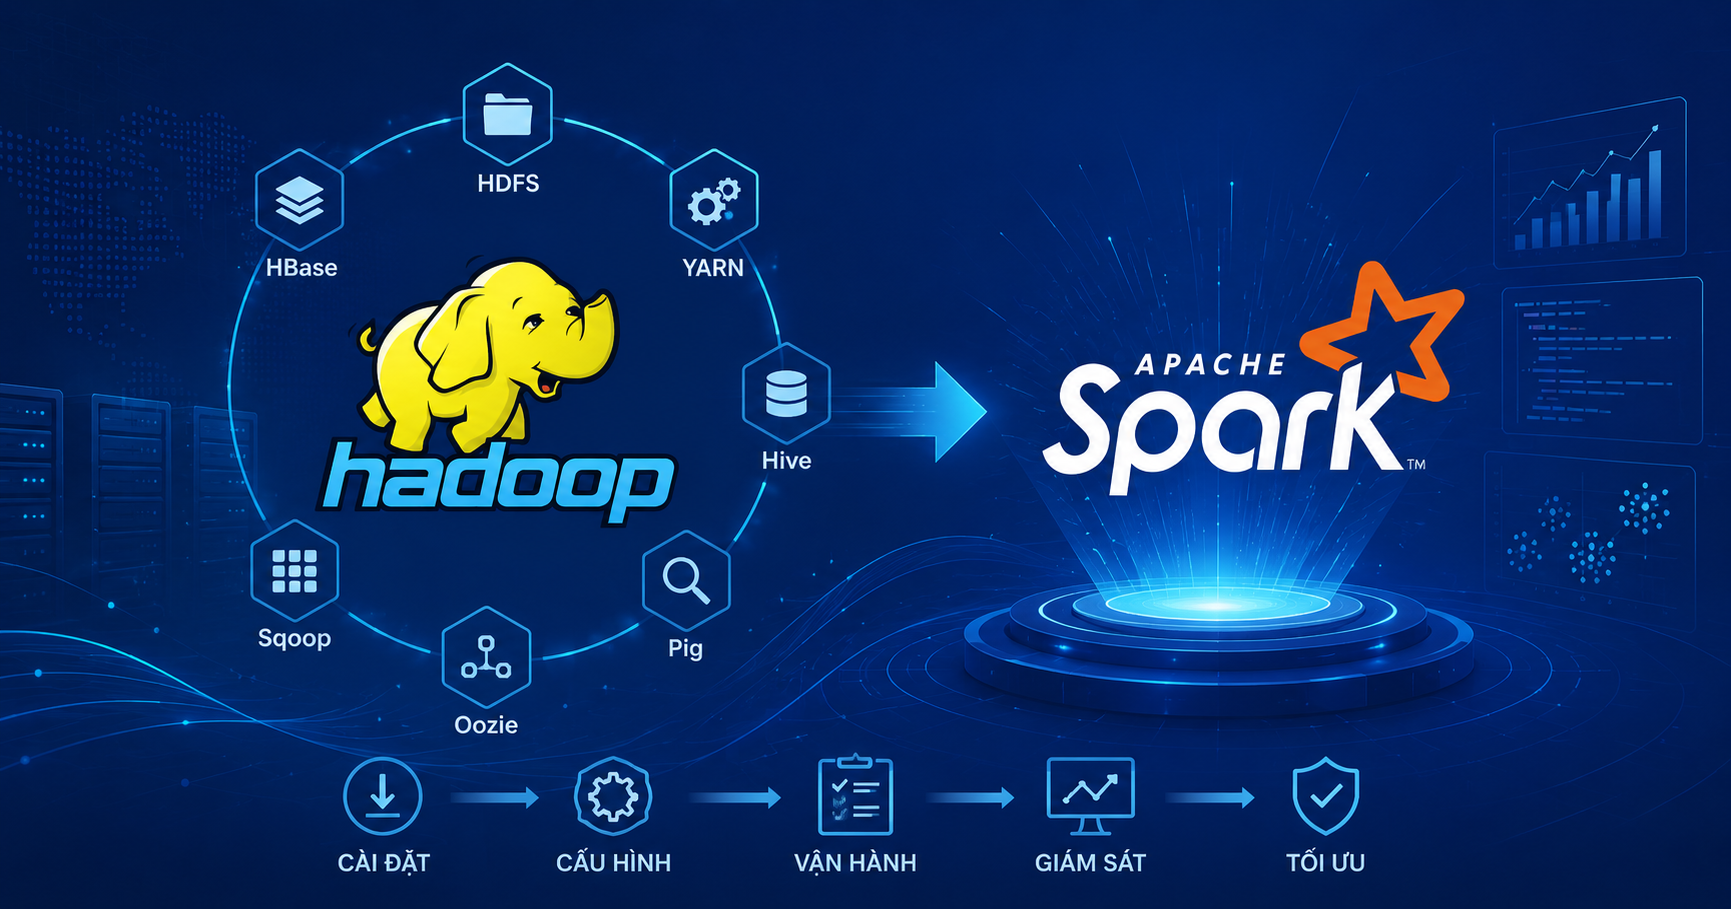
Hadoop Ecosystem: Cài đặt, Cấu hình và vận hành Apache Spark
Ở bài trước chúng ta đã sử dụng Hive và Hbase để truy vấn Database, tiếp tới trong các framework áp dụng cho Hadoop Ecosystem sẽ là Apache Spark, cơ s...
 BigData
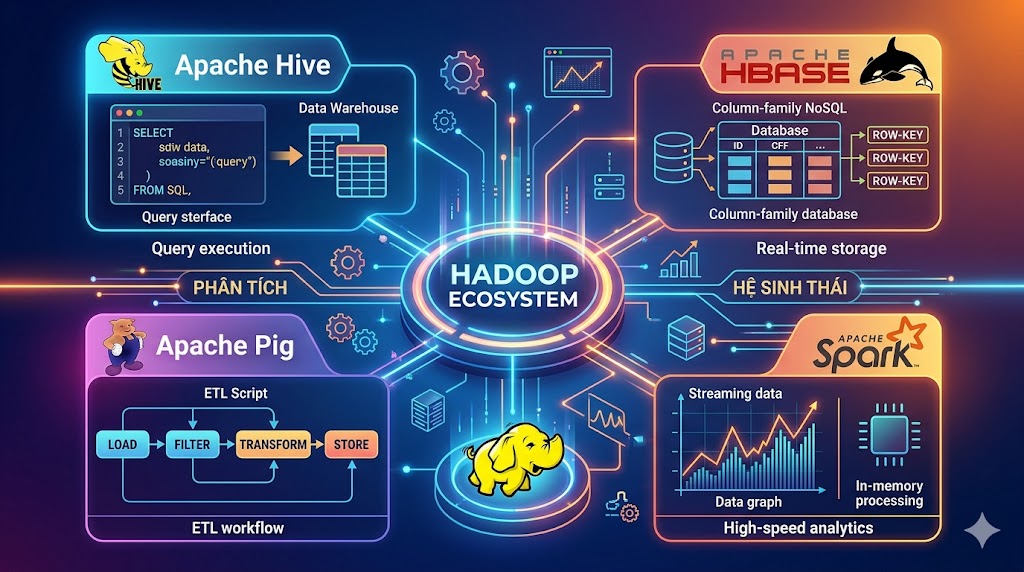
Phân Tích Hadoop Ecosystem: Hive, HBase, Pig, Spark là gì ?
1. Tổng quan về Hệ sinh thái Hadoop (Hadoop Ecosystem) Hadoop không chỉ là một phần mềm đơn lẻ mà là một hệ sinh thái mã nguồn mở bao gồm nhiều công c...
 Linux
Hadoop Ecosystem: Cài đặt, Cấu hình & Demo Apache Hive & HBase
Ở bài trước chúng ta đã xử lý dọn dẹp dữ liệu với Apache pig rồi, tiếp tới đây chúng ta sẽ sử dụng Apache Hive và Apache Hbase để truy vấn Data nhé. C...
 BigData
Apache Pig: Dọn dẹp dữ liệu khổng lồ trên Hadoop Cluster (ETL)
Giả sử bạn có một cụm Hadoop phân tán đang chạy mượt mà trên AWS và một file dữ liệu thô nặng hàng GB. Bạn không thể cứ thế đẩy thẳng nó vào SQL hay M...
 DevOps
Ansible: Cài Đặt Hadoop Cluster Trên Ubuntu 22.04
Triển khai Hadoop Eco System theo cách thủ công trên nhiều server thường tiêu tốn hàng giờ đồng hồ với hàng loạt thao tác lặp đi lặp lại. Để tối ưu hó...
 Linux
Cài Đặt Hadoop Single Node Cluster trên Ubuntu 24.04
Apache Hadoop là gì? Apache Hadoop là một framework mã nguồn mở (open-source) được phát triển bởi Apache Software Foundation, cho phép lưu trữ và xử l...